<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <id>https://caph.me/</id>
  <title type="text">Caph</title>
  <subtitle type="text">Personal Blog</subtitle>
  <updated>2026-08-08T00:00:00.000Z</updated>
  <author><name>Caph</name></author>
  <link rel="alternate" href="https://caph.me/"/>
  <link rel="self" href="https://caph.me/atom.xml"/>
  <generator uri="https://github.com/CuteLeaf/Firefly">Firefly v6.16.8</generator>
    <entry>
      <id>https://caph.me/posts/tools-progressive-disclosure/</id>
      <title type="text">Tools 的渐进式披露为什么这么难？</title>
      <published>2026-08-08T00:00:00.000Z</published>
      <updated>2026-08-08T00:00:00.000Z</updated>
      <author><name>Caph</name></author>
      <link rel="alternate" href="https://caph.me/posts/tools-progressive-disclosure/"/>
      <summary type="text">从 Provider 原生、客户端折中到协议改造，盘点业界实现工具渐进式加载的四种方案，以及「初始无 N 个工具、前缀缓存稳定、原生严格 schema」三个目标只能取二的取舍。</summary>
      <content type="html"><![CDATA[<section><h1>Tools 的渐进式披露为什么这么难？<a href="#tools-的渐进式披露为什么这么难"><span>#</span></a></h1><section><h2>0. 我们是怎么把 Agent 喂胖的<a href="#0-我们是怎么把-agent-喂胖的"><span>#</span></a></h2><p>把大模型看成一个函数：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>Response = LLM(System_Prompt, History, Tools, Skills)</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>做 Agent 时我们有个很常见的习惯：为了让它在长程任务里「不犯错」，把业务规范全部写进 System Prompt，把能想到的 API 全部注册成 Tools。</p><p>这种「暴力堆料」会撞上两面墙：</p><ul>
<li><strong>理论墙（信息论）</strong>：输入与期望输出之间的互信息决定了模型表现的上限。长程任务的决策树是指数膨胀的；为了覆盖所有分支而在开头塞入全部信息，那么对「当前这一步」的决策而言，大部分上下文是无效噪声。有效信息被淹没，模型调和冲突与「瞎猜」的空间变大，幻觉和偏离目标的概率随之飙升。</li>
<li><strong>工程墙（成本与延迟）</strong>：无限膨胀的上下文意味着难以忍受的首字延迟（TTFT）、飞速燃烧的 token 预算，以及超出 Prompt Cache 命中范围后的高昂算力成本。</li>
</ul><p>破局方向是<strong>渐进式披露</strong>（progressive disclosure）：不在一开始把所有知识甩给模型，而是给它一个目录/索引，让它按需检索和加载。Anthropic 的 Skills 机制把这个哲学带进了工程界——知识（Skills）可以渐进披露，那占据上下文另一大头的工具（Tools）行不行？</p><p>答案是可以，但是相比于 SKills 的渐进式披露，Tools 的渐进式披露要难得多得多。这篇文章盘点一下业界为了实现工具的渐进式加载，演变出了哪几种截然不同的方向。</p></section><section><h2>1. 底层机制：模型只会「吐 token」<a href="#1-底层机制模型只会吐-token"><span>#</span></a></h2><p>所有 Agent——Claude Code、Codex、Cursor 还是自研 harness——内部模型永远只做一件事：<strong>预测并输出下一个 token</strong>。所谓调用工具，本质是模型在某时刻按约定格式吐出的一段结构化文本。</p><p>一次请求长这样（简化）：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span></div></div><div><div><div>2</div></div><div><span>  </span><span>"messages"</span><span>: [{ </span><span>"role"</span><span>: </span><span>"user"</span><span>, </span><span>"content"</span><span>: </span><span>"查询北京天气"</span><span> }],</span></div></div><div><div><div>3</div></div><div><span>  </span><span>"tools"</span><span>: [</span></div></div><div><div><div>4</div></div><div><span><span>    </span></span><span>{</span></div></div><div><div><div>5</div></div><div><span>      </span><span>"name"</span><span>: </span><span>"get_weather"</span><span>,</span></div></div><div><div><div>6</div></div><div><span>      </span><span>"description"</span><span>: </span><span>"查询指定城市的天气"</span><span>,</span></div></div><div><div><div>7</div></div><div><span>      </span><span>"parameters"</span><span>: {</span></div></div><div><div><div>8</div></div><div><span>        </span><span>"type"</span><span>: </span><span>"object"</span><span>,</span></div></div><div><div><div>9</div></div><div><span>        </span><span>"properties"</span><span>: { </span><span>"city"</span><span>: { </span><span>"type"</span><span>: </span><span>"string"</span><span> } },</span></div></div><div><div><div>10</div></div><div><span>        </span><span>"required"</span><span>: [</span><span>"city"</span><span>]</span></div></div><div><div><div>11</div></div><div><span><span>      </span></span><span>}</span></div></div><div><div><div>12</div></div><div><span><span>    </span></span><span>}</span></div></div><div><div><div>13</div></div><div><span><span>  </span></span><span>]</span></div></div><div><div><div>14</div></div><div><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>模型如果决定调用工具，返回的是 Provider API 的原生结构：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span></div></div><div><div><div>2</div></div><div><span>  </span><span>"role"</span><span>: </span><span>"assistant"</span><span>,</span></div></div><div><div><div>3</div></div><div><span>  </span><span>"content"</span><span>: </span><span>null</span><span>,</span></div></div><div><div><div>4</div></div><div><span>  </span><span>"tool_calls"</span><span>: [</span></div></div><div><div><div>5</div></div><div><span><span>    </span></span><span>{ </span><span>"id"</span><span>: </span><span>"call_123"</span><span>, </span><span>"name"</span><span>: </span><span>"get_weather"</span><span>, </span><span>"arguments"</span><span>: { </span><span>"city"</span><span>: </span><span>"北京"</span><span> } }</span></div></div><div><div><div>6</div></div><div><span><span>  </span></span><span>]</span></div></div><div><div><div>7</div></div><div><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>注意 <code>tool_calls</code> 不是从普通文本里正则抠出来的，它通常还带一个 <code>finish_reason: "tool_calls"</code> 标记——这就是 harness 判断「模型在要求执行工具」的依据。至于 Provider 内部怎么让模型乖乖吐这种格式（特殊提示词格式、专用 tool-call token、输出阶段的 JSON Schema 约束），各家实现不同，但本质不变：<strong>输入多了工具定义，输出多了一个结构化的工具调用通道。</strong></p><section><h3>1.1 如果不注册呢？<a href="#11-如果不注册呢"><span>#</span></a></h3><p>不把工具放进 <code>tools</code> 数组，只在聊天消息里写一句「你可以调用 get_weather，参数是 {…}」，模型也能输出一段看起来很规整的 JSON——但它只是普通文本：Provider 不会标记 <code>finish_reason</code>，不会校验参数，不会给 <code>call_id</code>。本地程序必须自己解析、自己判断、自己校验。</p><p>这条「文本协议」路线在过去很流行：2023–2025 年的 ReAct、Claude Dev/Cline、Roo Code 和 Kilo Code 早期版本都是这么干的——在 System Prompt 里用 XML/Markdown 描述所有工具，模型按约定输出调用指令，客户端捕获符合格式的文本块后解析执行。它的历史价值是快速兼容不支持原生 Tool Calling 的模型渠道；代价是没有 Provider 层的语法约束，模型偶尔写跑偏（参数名拼错、少一个括号、自由发挥一段解释），可靠性全靠框架兜底。随着 Strict Tool Use、结构化输出等能力普及，这条路线慢慢退出了主流。</p></section><section><h3>1.2 算一笔账<a href="#12-算一笔账"><span>#</span></a></h3><p>结论先摆出来：<strong>要做原生 Tool Calling，工具就必须出现在请求的 <code>tools</code> 参数里。Provider 在推理开始前就要拿到所有工具的完整契约</strong>，否则无法建立语法约束，也就无法产出合法的原生 tool call。听起来像「人被杀就会死」一样自然——直到我们期望一个 Agent 在会话中灵活调度上百个工具。</p><p>按原文的保守估算：一个工具定义（名称 + 描述 + 参数 Schema）平均 400 token，200 个工具就是 <strong>80k token</strong>。主流旗舰模型的实际可用上下文窗口虽然几个月内从 150k 涨到了 400–500k，但注意力机制在大量低相关性工具描述上仍会产生信息稀释与「上下文腐烂」——窗口变大，不等于可以当败家子。</p></section><section><h3>1.3 Skills 容易，Tools 难<a href="#13-skills-容易tools-难"><span>#</span></a></h3><p>Skills 之所以能优雅地渐进披露，是因为它的本质是纯文本内容：用户提问 → 模型判断需要某 Skill → 客户端把对应 markdown 追加到消息末尾。关键点在于：<strong>所有信息增量都发生在消息末尾，不碰请求最前方的任何结构。</strong></p><p>这对 <strong>Prompt Cache</strong> 机制极其友好：主流 Provider（Anthropic、OpenAI）的缓存逻辑是「两次连续请求的前缀在 token 层面完全一致，就直接复用上一次的 KV 计算结果」——哪怕只修改或插入一个 token，后续缓存全部作废。Skills 的加载方式恰好不动前缀，庞大的基础上下文稳定命中缓存。</p><p>但 Tools 不同。原生 Tool Calling 要求工具定义出现在 <code>tools</code> 参数里，而 <code>tools</code> 数组永远驻扎在请求的最前端。设想：Agent 有 200 个工具，第一轮只注册 5 个高频的；第三轮模型需要「创建 PDF」工具，客户端只剩两条路：</p><ul>
<li><strong>改 <code>tools</code> 数组</strong> → 请求最前方的结构变了 → 整个 Prompt Cache 报废 → 几万甚至几十万 token 的历史全部重算，又慢又贵；</li>
<li><strong>不改</strong> → 让模型在普通对话里按格式纯文本输出参数 → 失去原生调用的一切保障，参数幻觉和格式错误由客户端兜底。</li>
</ul><p>于是核心死结出现了：</p><blockquote><p><strong>原生工具调用的可信度建立在「Provider 在推理前就知道所有工具的完整契约」这一前提上；而渐进式披露的本质是「推理前坚决不让 Provider 知道所有工具」。这两个需求在系统结构上是天然互斥的。</strong></p></blockquote><p>理解了这一点，才能看懂下面四种方案各自在跟什么较劲。</p></section></section><section><h2>2. 四种方案横评<a href="#2-四种方案横评"><span>#</span></a></h2><section><h3>2.1 方案一（Provider 原生）：Anthropic Tool Search Tool<a href="#21-方案一provider-原生anthropic-tool-search-tool"><span>#</span></a></h3><p>Anthropic 在 2025 年 11 月发布 Tool Search Tool。原理上，客户端<strong>仍然把全部工具契约发给 Anthropic</strong>，但把不那么必要的工具标上 <code>defer_loading</code>——被标注的工具不会进入模型初始上下文，Anthropic 在服务端维护一个隐藏的工具目录：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span></div></div><div><div><div>2</div></div><div><span>  </span><span>"tools"</span><span>: [</span></div></div><div><div><div>3</div></div><div><span><span>    </span></span><span>{ </span><span>"type"</span><span>: </span><span>"tool_search_tool_bm25_20251119"</span><span>, </span><span>"name"</span><span>: </span><span>"tool_search_tool_bm25"</span><span> },</span></div></div><div><div><div>4</div></div><div><span><span>    </span></span><span>{</span></div></div><div><div><div>5</div></div><div><span>      </span><span>"name"</span><span>: </span><span>"learning_create_cards"</span><span>,</span></div></div><div><div><div>6</div></div><div><span>      </span><span>"description"</span><span>: </span><span>"Create learning cards..."</span><span>,</span></div></div><div><div><div>7</div></div><div><span>      </span><span>"input_schema"</span><span>: { </span><span>"..."</span><span>: </span><span>"完整严格 schema"</span><span> },</span></div></div><div><div><div>8</div></div><div><span>      </span><span>"defer_loading"</span><span>: </span><span>true</span></div></div><div><div><div>9</div></div><div><span><span>    </span></span><span>}</span></div></div><div><div><div>10</div></div><div><span><span>  </span></span><span>]</span></div></div><div><div><div>11</div></div><div><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>模型需要某工具时，调用搜索工具（BM25 变体接受自然语言查询，上限 500 字符；regex 变体让模型自己写 <code>re.search()</code> 正则，上限 200 字符；两者都搜索工具名、描述、参数名和参数描述），Provider 在服务端检索后返回特殊的引用：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{ </span><span>"type"</span><span>: </span><span>"tool_reference"</span><span>, </span><span>"tool_name"</span><span>: </span><span>"learning_create_cards"</span><span> }</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>随后 Provider 在<strong>当前对话位置</strong>把这个引用展开成完整工具定义——搜索结果和最终的工具调用甚至可以出现在同一次 assistant response 里，客户端只需要执行最终的具体工具。</p><p>缓存为什么没坏？关键在于 <code>defer_loading</code> 的特殊语义：完整定义是在<strong>发现位置追加</strong>的，没有回头修改最前面的工具前缀。历史消息里出现过的 <code>tool_reference</code> 会被 API 全程展开，模型后续轮次可以直接复用已发现的工具，无需重新搜索。</p><p><strong>短板</strong>：强绑定 Anthropic。OpenAI 自家的 Responses API 提供了同构的 <code>tool_search</code> + <code>defer_loading</code>（支持按需加载 Function、Namespace 和 MCP 工具），但广大 OpenAI 兼容生态——vLLM、OpenRouter、各家自建兼容层——通常只能二选一：发送 <code>tools</code> 就全部进模型上下文，不发送 Provider 就不承认对应的原生调用。它们缺少 <code>defer_loading</code> / <code>tool_reference</code> 这种 Provider 级协议，于是才有了下面两条客户端自救路线。</p></section><section><h3>2.2 方案二（客户端折中）：Stub 注册 + load_tool_schemas<a href="#22-方案二客户端折中stub-注册--load_tool_schemas"><span>#</span></a></h3><p>既然 <code>tools</code> 数组一个字都不能动，那就「注册全部工具、但把未被需要的契约压缩到极限」。这是原文作者自己实现过的方案：</p><ul>
<li>每个真实工具注册成一个 <strong>stub</strong>：保留真实工具名，描述压到一句话，参数契约换成宽松的万能外壳；</li>
<li>工具列表常驻一个客户端实现的 <code>load_tool_schemas</code> 工具。</li>
</ul><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span></div></div><div><div><div>2</div></div><div><span>  </span><span>"name"</span><span>: </span><span>"learning_create_cards"</span><span>,</span></div></div><div><div><div>3</div></div><div><span>  </span><span>"description"</span><span>: </span><span>"从学习笔记创建记忆卡片。调用前必须先调用 load_tool_schemas 获取完整参数契约。"</span><span>,</span></div></div><div><div><div>4</div></div><div><span>  </span><span>"parameters"</span><span>: {</span></div></div><div><div><div>5</div></div><div><span>    </span><span>"type"</span><span>: </span><span>"object"</span><span>,</span></div></div><div><div><div>6</div></div><div><span>    </span><span>"properties"</span><span>: { </span><span>"arguments"</span><span>: { </span><span>"type"</span><span>: </span><span>"object"</span><span>, </span><span>"additionalProperties"</span><span>: </span><span>true</span><span> } }</span></div></div><div><div><div>7</div></div><div><span><span>  </span></span><span>}</span></div></div><div><div><div>8</div></div><div><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>调用流程：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>模型认为自己需要制卡能力</span></div></div><div><div><div>2</div></div><div><span><span>  </span></span><span>→ 调 load_tool_schemas({ "tools": ["learning_create_cards"] })</span></div></div><div><div><div>3</div></div><div><span><span>  </span></span><span>→ 客户端把完整 JSON Schema 作为普通 tool_result 消息返回</span></div></div><div><div><div>4</div></div><div><span><span>    </span></span><span>（追加在对话尾部，不碰任何前缀，缓存安全）</span></div></div><div><div><div>5</div></div><div><span><span>  </span></span><span>→ 模型按刚拿到的 schema 调用对应的 stub</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>账很好算：200 个工具从约 80k token 压到约 15k（每个 stub 约 60–80 token），降低约 80%。</p><p><strong>短板</strong>：这是「半原生」方案——stub 数量依然是 O(N)，没有实现真正的按需加载，每个 stub 都常驻上下文、真实占用注意力；Provider 的语法约束约束的是那个宽松外壳，真实参数的合法性完全靠客户端自己保证。</p></section><section><h3>2.3 方案三（客户端激进）：search_tools + invoke_tool<a href="#23-方案三客户端激进search_tools--invoke_tool"><span>#</span></a></h3><p>再进一步。注册工具有两个基本前提——「工具在 Provider 注册」和「模型能遵守契约」。第一条可以收窄到极限：注册<strong>一个</strong>全能力工具；第二条随着旗舰模型指令遵循能力的提升，「把契约以文本形式交给模型、它照着填参数」已相当可靠：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span></div></div><div><div><div>2</div></div><div><span>  </span><span>"name"</span><span>: </span><span>"invoke_tool"</span><span>,</span></div></div><div><div><div>3</div></div><div><span>  </span><span>"description"</span><span>: </span><span>"执行工具目录中的工具。请先用 search_tools 找到目标工具，再按返回的契约填写 arguments。"</span><span>,</span></div></div><div><div><div>4</div></div><div><span>  </span><span>"parameters"</span><span>: {</span></div></div><div><div><div>5</div></div><div><span>    </span><span>"type"</span><span>: </span><span>"object"</span><span>,</span></div></div><div><div><div>6</div></div><div><span>    </span><span>"properties"</span><span>: {</span></div></div><div><div><div>7</div></div><div><span>      </span><span>"tool_name"</span><span>: { </span><span>"type"</span><span>: </span><span>"string"</span><span> },</span></div></div><div><div><div>8</div></div><div><span>      </span><span>"arguments"</span><span>: { </span><span>"type"</span><span>: </span><span>"object"</span><span>, </span><span>"additionalProperties"</span><span>: </span><span>true</span><span> }</span></div></div><div><div><div>9</div></div><div><span><span>    </span></span><span>},</span></div></div><div><div><div>10</div></div><div><span>    </span><span>"required"</span><span>: [</span><span>"tool_name"</span><span>, </span><span>"arguments"</span><span>]</span></div></div><div><div><div>11</div></div><div><span><span>  </span></span><span>}</span></div></div><div><div><div>12</div></div><div><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p><code>tools</code> 数组从此恒定，只有 <code>search_tools</code> 和 <code>invoke_tool</code> 两个：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>1. 模型 → search_tools({ "query": "create flashcards from study notes" })</span></div></div><div><div><div>2</div></div><div><span>2. 客户端 → 返回目录条目（工具名 + 一行描述，不含完整 schema）</span></div></div><div><div><div>3</div></div><div><span>3. 模型 → invoke_tool({ "tool_name": "learning_create_cards", "arguments": { "notes": "..." } })</span></div></div><div><div><div>4</div></div><div><span>4. 客户端 → 按 tool_name 取出真实 schema 校验 → 执行 → 回传结果</span></div></div><div><div><div>5</div></div><div><span><span>   </span></span><span>（校验失败 → 返回结构化错误 → agent 修正重试）</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>初始上下文占用从 O(N) 直接变成 O(1)——工具目录里躺 100 个还是 10,000 个工具，模型永远只看到两个（几百 token）。目录本身可以是本地索引、数据库表甚至 embedding 检索服务，检索自由度在自己手里。</p><p><strong>代价</strong>：Provider 只认识 <code>invoke_tool</code> 的外层 schema，不认识内层 schema——外层有语法约束，<code>arguments</code> 内部却是不设防的黑盒，真实校验必须客户端全权承担，失败就返回结构化错误让 agent 修正；真实参数变成「JSON 里的 JSON」，多一层转义与嵌套；且对模型指令遵循能力有门槛，弱模型会在第 3 步频繁出错。</p><p><strong>补偿</strong>：所有具体调用收敛到同一个入口后，校验、授权、审计、限流这些横切关注点只需要在 Gateway 一处实现——多用户/多 Agent 场景下是意外之喜。</p></section><section><h3>2.4 方案四（Provider 原生 + 协议改造）：Kimi K3 动态加载工具<a href="#24-方案四provider-原生--协议改造kimi-k3-动态加载工具"><span>#</span></a></h3><p>Moonshot 在 Kimi K3 的 API 里提供「动态加载工具」机制，思路是：<strong>工具声明不一定要待在请求开头的 <code>tools</code> 字段里，它可以是一条消息。</strong></p><div><div><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span></div></div><div><div><div>2</div></div><div><span>  </span><span>"messages"</span><span>: [</span></div></div><div><div><div>3</div></div><div><span><span>    </span></span><span>{ </span><span>"role"</span><span>: </span><span>"system"</span><span>, </span><span>"content"</span><span>: </span><span>"You are Kimi, an AI assistant..."</span><span> },</span></div></div><div><div><div>4</div></div><div><span><span>    </span></span><span>{ </span><span>"role"</span><span>: </span><span>"user"</span><span>, </span><span>"content"</span><span>: </span><span>"Calculate fuel consumption."</span><span> },</span></div></div><div><div><div>5</div></div><div><span><span>    </span></span><span>{</span></div></div><div><div><div>6</div></div><div><span>      </span><span>"role"</span><span>: </span><span>"system"</span><span>,</span></div></div><div><div><div>7</div></div><div><span>      </span><span>"tools"</span><span>: [</span></div></div><div><div><div>8</div></div><div><span><span>        </span></span><span>{</span></div></div><div><div><div>9</div></div><div><span>          </span><span>"type"</span><span>: </span><span>"function"</span><span>,</span></div></div><div><div><div>10</div></div><div><span>          </span><span>"function"</span><span>: {</span></div></div><div><div><div>11</div></div><div><span>            </span><span>"name"</span><span>: </span><span>"Calculator"</span><span>,</span></div></div><div><div><div>12</div></div><div><span>            </span><span>"description"</span><span>: </span><span>"计算器，只支持单个算术表达式的求值"</span><span>,</span></div></div><div><div><div>13</div></div><div><span>            </span><span>"parameters"</span><span>: {</span></div></div><div><div><div>14</div></div><div><span>              </span><span>"type"</span><span>: </span><span>"object"</span><span>,</span></div></div><div><div><div>15</div></div><div><span>              </span><span>"properties"</span><span>: { </span><span>"expr"</span><span>: { </span><span>"type"</span><span>: </span><span>"string"</span><span> } },</span></div></div><div><div><div>16</div></div><div><span>              </span><span>"required"</span><span>: [</span><span>"expr"</span><span>]</span></div></div><div><div><div>17</div></div><div><span><span>            </span></span><span>}</span></div></div><div><div><div>18</div></div><div><span><span>          </span></span><span>}</span></div></div><div><div><div>19</div></div><div><span><span>        </span></span><span>}</span></div></div><div><div><div>20</div></div><div><span><span>      </span></span><span>]</span></div></div><div><div><div>21</div></div><div><span><span>    </span></span><span>}</span></div></div><div><div><div>22</div></div><div><span><span>  </span></span><span>]</span></div></div><div><div><div>23</div></div><div><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure><div></div></div><span>展开</span><span>收起</span></div></div><p>关键语义：携带 <code>tools</code> 的 system 消息与普通消息地位相同——<strong>它出现在 <code>messages</code> 的哪个位置，工具就从哪个位置开始对模型可见</strong>；动态加载的工具与顶层声明的全局工具并存；声明必须是完整定义，不能只传工具名；这条消息不能再带 <code>content</code> 字段，否则请求报 400。</p><p>缓存规则官方给了四条：</p>

<table><thead><tr><th>操作</th><th>对前缀缓存的影响</th></tr></thead><tbody><tr><td>在 <code>messages</code> 末尾追加工具声明</td><td>不影响已有前缀缓存</td></tr><tr><td>后续请求原样保留已注入的工具声明</td><td>前缀稳定，有利于持续命中缓存</td></tr><tr><td>删除、修改对话中间的消息，或中间插入新声明</td><td>变更位置之后的缓存可能无法命中</td></tr><tr><td>在顶层 <code>tools</code> 字段声明全局工具</td><td>不影响缓存命中</td></tr></tbody></table><p>总结成一句话：<strong>追加，不要插入；注入了就别删。</strong> 工具声明被当成普通对话内容的一部分往后追加，前缀纹丝不动——和 Skills 的加载路径一模一样。</p><p>官方参考实现也很朴素：顶层只注册客户端实现的 <code>search_tools</code> → system prompt 里告诉模型工具目录/领域关键词 → 模型需要时先 search → 应用把命中工具的完整声明追加到末尾 → 模型原生调用。</p><p>我的评价：这是<strong>协议层面</strong>的改造，不需要 <code>defer_loading</code>、<code>tool_reference</code> 这类新概念，声明格式与顶层 <code>tools</code> 完全一致；位置语义直觉且可控，天然缓存友好；同时保留 Provider 侧的原生约束，不会像 <code>invoke_tool</code> 那样把参数黑盒化。原文作者说它「十分优雅，令人眼馋」，我同意。</p><p>旁证：Anthropic 在 2026 年 7 月推出的 mid-conversation system messages 和 tool changes，也允许通过对话中途的 system message 添加或移除工具并保留前缀缓存——但没有人回头重新采用 Kimi 的方案。这个「为什么」很有意思，见 4.3 节。</p></section></section><section><h2>3. 取舍：三个目标，只能要两个<a href="#3-取舍三个目标只能要两个"><span>#</span></a></h2><p>把四个方案抽象一下，会发现三个互相拉扯的目标：</p><ol>
<li>初始上下文不包含 N 个具体工具或 Stub；</li>
<li>工具列表始终稳定，不破坏早期 Prompt Cache；</li>
<li>每个具体工具仍以独立原生工具 + 严格 schema 被 Provider 调用、约束。</li>
</ol><p>没有 Provider 原生配合时，三者只能取二：</p>

<table><thead><tr><th>选择</th><th>结果</th></tr></thead><tbody><tr><td>缓存稳定 + 具体工具原生调用</td><td>必须常驻 N 个真实工具或 Stub（对应方案二）</td></tr><tr><td>初始无 N 个工具 + 具体工具原生调用</td><td>发现后动态修改 <code>tools</code>，破坏早期缓存</td></tr><tr><td>缓存稳定 + 初始无 N 个工具</td><td>只能常驻一个通用调用外壳，由客户端还原并校验（对应方案三）</td></tr></tbody></table><p>所以没有「最好的方案」，只有「最适合的取舍」——取决于三个工程变量：</p><ul>
<li><strong>工具规模</strong>：不到 20 个工具就全量注册，别折腾。社区里 CJackHwang 提到一个反直觉的点：工具数量少的时候，渐进式披露因为多出检索步骤，长任务下消耗的 token 反而更多。「没有最好的，只有最适合的」。</li>
<li><strong>Provider 绑定程度</strong>：工具多且目标 Provider 支持原生机制（Anthropic / Moonshot），优先用原生方案，别自己造轮子；要兼容 vLLM、OpenRouter、自建网关等多后端，方案三才是通解。</li>
<li><strong>任务形态</strong>：长程多轮任务里缓存命中的收益被放大，方案二/三的「前缀稳定」价值更高；一次性短任务直接全量注册更划算。</li>
</ul><section><h3>3.1 社区补充思路<a href="#31-社区补充思路"><span>#</span></a></h3><p>原文评论区一百多楼里，有几条值得记下的补充：</p><ul>
<li><strong>bash/CLI 收敛</strong>：只暴露一个 bash 工具（或「伪 bash」），把其他工具下沉成 CLI，靠 <code>--help</code> 完成逐层披露。Vercel 的 just-bash、Pi 的思路（五六个极简工具覆盖读写与 bash，每个描述只有一句话、三四十个单词）都是这个路线。本质上把披露从 Provider 协议层挪到了命令行环境。适用面仅限于能跑 OS 的 Agent——跑在业务系统内部的 Agent 用不了 bash（社区里 jelly15 的疑问）。</li>
<li><strong>大小模型协同</strong>：bod 提出用便宜快的模型（如 DS V4 Flash）在会话/子 Agent 开始时先做一次工具编排预筛选，把可能用到的工具提前挑进新上下文，loop 里再让便宜模型做上下文整理、预压缩的杂活。</li>
<li><strong>子代理专职校验</strong>：LLMeme 提出起一个子 Agent 专门负责输出/校验工具调用（本质是 <code>invoke_tool</code> 的加强版）。反对意见也很实在：子 Agent 转述损失信息、增加延迟、双上下文管理复杂度。</li>
<li><strong>一条重要的实测反例</strong>：yuwkGoo 在 pi agent 上试过 <code>invoke_tool</code> + <code>search_tools</code>，结果是 <strong>grok 4.5 基本不再调用工具了</strong>（除了 GPT 系，其他模型普遍有这个倾向）；后来改用本地 BM25 做轻量 tool search，效果反而更好。这条反馈直接说明：方案三的成败不只在架构，更在<strong>检索质量</strong>——模型找不到、搜不准，就不会用。</li>
</ul></section></section><section><h2>4. 我的思考<a href="#4-我的思考"><span>#</span></a></h2><p>（本节全部是个人推演与设计方案，不是实验结论。）</p><section><h3>4.1 如果让我选，我会怎么选<a href="#41-如果让我选我会怎么选"><span>#</span></a></h3><p>第一步不是选方案，而是<strong>量化</strong>：工具总数、平均定义长度、单会话实际激活的工具数、当前缓存命中率。不量化就上方案，是拍脑袋。在此基础上我的排序是：</p><ul>
<li>工具 &lt; 20：全量注册。省心，且渐进披露的额外请求成本未必划算。</li>
<li>工具多 + 目标 Provider 有原生机制：优先 <code>defer_loading</code>（Anthropic）或动态加载（Moonshot）。协议层面兼容缓存，参数校验不黑盒，工程成本最低。</li>
<li>工具多 + 自建/多后端兼容：方案三为主，但必须把<strong>本地工具检索质量</strong>当一级指标来做（BM25 起步，目录规模大到语义检索有用再上 embedding），并接受「客户端校验代码会膨胀」的事实——校验逻辑写在哪，复杂度就在哪，这就是把黑盒从 Provider 挪到客户端的代价。</li>
<li>工具 schema 极复杂 + 团队短期不想写通用校验器：方案二（stub）是合理过渡。</li>
</ul><p>关于社区里「通用工具 vs 特化工具」的争论（「四肢健全」论 vs 特化论），我的看法是两者不矛盾：<strong>通用外壳负责寻址与横切，特化 schema 负责参数语义</strong>。真正的分界在「谁维护索引」：内部系统 Agent 的工具集稳定，索引成本低，特化 schema 价值高；跨团队共用的工具网关，通用外壳 + 统一审计限流反而更值。</p></section><section><h3>4.2 如果要落地，我会怎么验证<a href="#42-如果要落地我会怎么验证"><span>#</span></a></h3><p>方案之间的争议大多停留在观点层面，缺可复现的对照实验。如果我来做，会这样设计：</p><ul>
<li>同一任务集（覆盖各工具的使用频率梯度），分别跑「全量注册」和候选方案；</li>
<li>观测指标：工具调用成功率、参数错误率、单任务总 token 消耗、TTFT、缓存命中率、任务完成率；</li>
<li>先埋点 2 周拿基线，再单场景灰度，最后全量。</li>
</ul><p>指标口径必须先写清楚——「缓存命中率」按请求数还是按 token 数算，结论会完全不同。</p></section><section><h3>4.3 三个问题<a href="#43-三个问题"><span>#</span></a></h3><ol>
<li>
<p><strong>位置敏感性问题</strong>：大模型对首尾的 prompt 更敏感，工具契约出现在对话中间（Kimi 方案的形态），模型遵循契约的能力会不会下降？</p>
<p>「不好说塞满 80k 契约的 agent 和渐进披露之后的 agent 哪个更差」。</p>
<p>如果 Kimi 方案要广泛落地，这是最值得先做对照实验的点。</p>
</li>
<li>
<p><strong>净账问题</strong>：渐进披露增加请求次数，减少了单次成本，长任务下到底省不省？我猜存在一个阈值。但是具体的阈值在哪里，需要进一步测试。</p>
</li>
<li>
<p><strong>方案收敛悬念</strong>：Kimi 方案被证明可行（Anthropic 2026 年 7 月也做了 mid-conversation tool changes 且保留缓存），为什么主流 harness 没有跟进？一方面可以说是积重难返，还有一层是：工具声明一旦可以出现在消息序列里，prompt injection 的攻击面也随之增大——社区里也有人提到过「权威性」与注入风险的考虑。</p>
</li>
</ol></section><section><h3>4.4 这篇文章对我的修正<a href="#44-这篇文章对我的修正"><span>#</span></a></h3><p>读这篇文章之前，我对工具加载的理解停留在「全量注册 + 增大上下文窗口」的层面，顶多听说过「MCP 工具多了会挤占上下文」。最改变我看法的一点是：<strong>工具动态加载的瓶颈不是检索算法，而是请求结构</strong>——<code>tools</code> 数组在前缀里的位置决定了它与 Prompt Cache 的天然冲突，这个约束比「工具多不多」深刻得多。以后评估任何「工具按需加载」方案，我都会先问一句：它动了请求前缀吗？</p></section></section></section>]]></content>
    </entry>
    <entry>
      <id>https://caph.me/posts/trellis-ai-coding-framework/</id>
      <title type="text">Trellis：Spec-Driven Development 框架</title>
      <published>2026-07-18T00:00:00.000Z</published>
      <updated>2026-07-18T00:00:00.000Z</updated>
      <author><name>Caph</name></author>
      <link rel="alternate" href="https://caph.me/posts/trellis-ai-coding-framework/"/>
      <summary type="text">给团队同事的一篇介绍：Trellis 想解决什么问题，它怎样用 hook 自动注入上下文、让团队共享规范、让 AI 跨会话记住项目，以及上手前该知道的代价。</summary>
      <content type="html"><![CDATA[<section><h1>Trellis：Spec-Driven Development 框架<a href="#trellisspec-driven-development-框架"><span>#</span></a></h1><p>最近我在用 Trellis，用下来觉得值得跟大家讲一讲。</p><p>先说我们大概都碰到过的几件事。同一个需求，今天让 AI 写一遍，明天换个会话再写一遍，风格能差很多。新开一个会话，上次聊好的约定它全忘了，得再讲一遍。还有团队里那些不成文的规矩，比如错误怎么返回、目录怎么分，都在 PR 评论和老同事脑子里，AI 看不到，只能按它自己的习惯来写。</p><p>Trellis 想解决的就是这几件事。它的做法也不复杂：把规范、任务、会话记录都放进仓库，再用 hook 在合适的时候把它们送到 AI 面前。</p><p>官网的说法是，AI 的能力像藤蔓一样生长，充满活力但四处蔓延，Trellis 是给它搭的脚手架（trellis 本来就是花架的意思），引导它沿着你们定的路径走。</p><section><h2>它长什么样<a href="#它长什么样"><span>#</span></a></h2><p>装好之后，仓库里会多一个 <code>.trellis/</code> 目录，里面主要三样东西：</p>

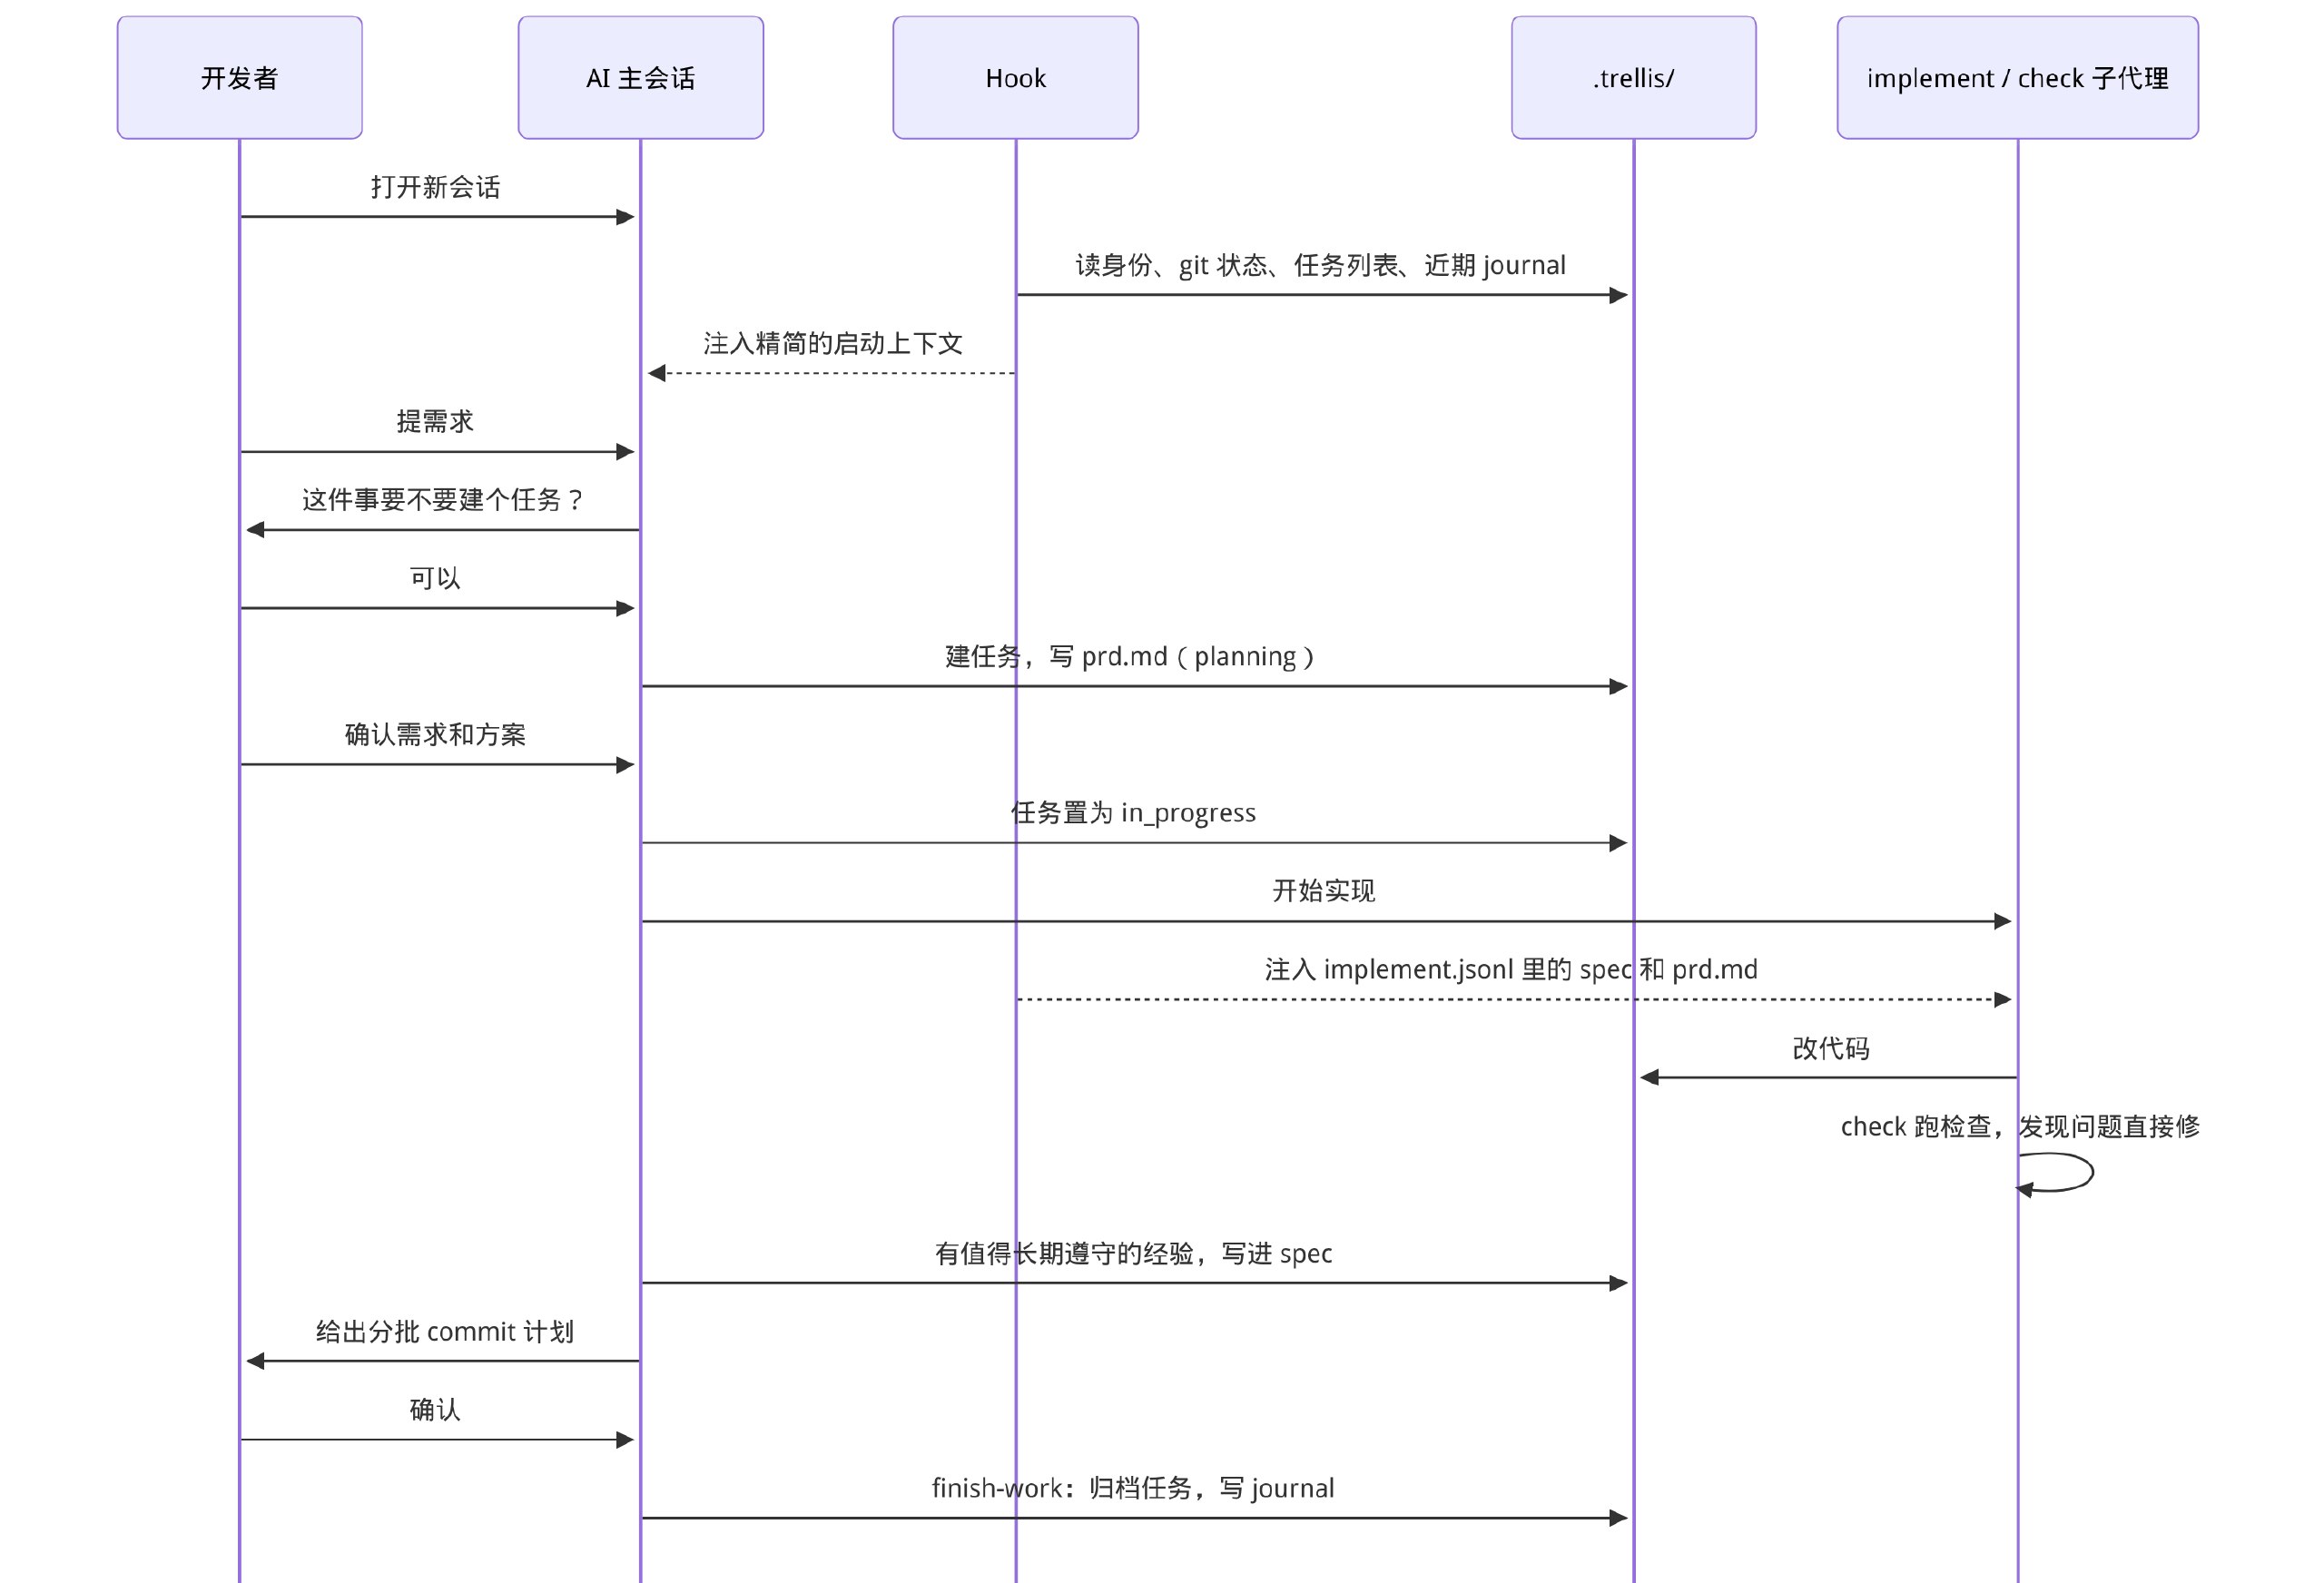
<table><thead><tr><th>目录</th><th>放什么</th></tr></thead><tbody><tr><td><code>.trellis/spec/</code></td><td>团队的编码规范，Markdown 写的，按 frontend、backend、guides 分文件</td></tr><tr><td><code>.trellis/tasks/</code></td><td>一个任务一个目录，里面有需求文档 <code>prd.md</code>，复杂任务还有设计和实施计划</td></tr><tr><td><code>.trellis/workspace/</code></td><td>每个开发者自己的会话日志（journal）</td></tr></tbody></table><p>此外还有 <code>.trellis/workflow.md</code>，写的是整个工作流怎么走。这些东西都是普通文件，能 diff、能 review、能进 git。</p><p><code>.trellis/</code> 这一套不绑定某个 AI 工具。Cursor、Claude Code、Codex、OpenCode 这些，加起来官方列了 20 多个平台，各自在自己的配置目录里装一层适配（hook、命令、子代理），读的是同一个 <code>.trellis/</code>。</p></section><section><h2>一个会话是怎么跑的<a href="#一个会话是怎么跑的"><span>#</span></a></h2><p>先看一次完整的流程，后面讲的设计点基本都在这张图里。</p><p></p><figure><img src="https://imgbed.caph.me/file/1791913559510_image.png" alt="Trellis 一次完整会话的协作流程：开发者、AI 主会话、Hook、.trellis/ 和 implement/check 子代理之间的交互" /><figcaption>Trellis 一次完整会话的协作流程：开发者、AI 主会话、Hook、.trellis/ 和 implement/check 子代理之间的交互</figcaption></figure><p></p><p>整体分三段：Plan、Execute、Finish。<code>workflow.md</code> 里把每一段该做什么、怎么切换写得很具体。</p><p>几个细节我觉得挺实在：</p><ul>
<li>要不要建任务，AI 会先问你。简单问答、小改动可以直接做，不会为了走流程硬建任务。</li>
<li>同意建任务，不等于同意开始写代码。中间还有一次需求和方案的确认，确认完才进入实现。</li>
<li>实现完有 <code>trellis-check</code> 来复核，它不只是报告问题，能修的会直接修，修完再跑一遍检查。</li>
<li>commit 是主会话先列一个分批计划，你点头一次，它再提交。<code>finish-work</code> 只负责归档和写 journal，不碰业务代码。</li>
</ul></section><section><h2>几处设计上的巧思<a href="#几处设计上的巧思"><span>#</span></a></h2><section><h3>Hook：该给的上下文自动给<a href="#hook该给的上下文自动给"><span>#</span></a></h3><p>规范写得再好，要靠人每次记得去贴，迟早会漏。Trellis 的思路是别靠人。</p><p>在支持 hook 的平台上，有三个时机会自动注入：</p><ul>
<li>会话启动时，注入开发者身份、当前 git 状态、进行中的任务、spec 索引和你最近的 journal。注入的是一份索引和状态报告，不会把所有文档整个塞进去。</li>
<li>每条消息发出时，注入一小段当前任务状态对应的提示，让 AI 清楚现在在哪个阶段、下一步该做什么。这段文字写在 <code>workflow.md</code> 里，想改流程就改这个文件，不用去改 hook 脚本。</li>
<li>子代理启动前，把这个任务需要的 spec 和需求文档注入给它。</li>
</ul><p>所以你不用每次开场先说一遍”先读一下规范”。写一次，之后每次都在。</p><p>没有 hook 的平台也有办法：靠 <code>AGENTS.md</code> 之类每次必读的入口文件，让 AI 自己去读。效果会差一点，文档里也写明了各平台的能力差异。</p></section><section><h3>按任务给 spec，不是一股脑全灌<a href="#按任务给-spec不是一股脑全灌"><span>#</span></a></h3><p>最常见的做法是写一个很大的 <code>CLAUDE.md</code> 或 <code>.cursorrules</code>，每次全塞进去。文件一长，容易被截断，模型也容易抓不住重点。</p><p>Trellis 把 spec 拆成多个文件，再用任务目录里的 <code>implement.jsonl</code> 和 <code>check.jsonl</code> 列出”这次实现要读哪几份、这次检查要读哪几份”。每行就是一个文件路径加一句理由：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>{</span><span>"file"</span><span>: </span><span>".trellis/spec/backend/error-handling.md"</span><span>, </span><span>"reason"</span><span>: </span><span>"接口错误格式"</span><span>}</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>这样做前端任务的时候，不会把数据库规范也带进来。清单里只放 spec 和调研文档，不放要改的源码。</p></section><section><h3>Spec 绑定代码路径（动态加载）<a href="#spec-绑定代码路径动态加载"><span>#</span></a></h3><p>这是官方文档里标成 beta 的一个功能，我觉得思路很好。你可以在 spec 的 frontmatter 里写 <code>paths</code>，声明它约束哪些文件：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>---</span></div></div><div><div><div>2</div></div><div><span>name</span><span>: </span><span>commands-workflow</span></div></div><div><div><div>3</div></div><div><span>description</span><span>: </span><span>Workflow command and resolver contracts</span></div></div><div><div><div>4</div></div><div><span>paths</span><span>:</span></div></div><div><div><div>5</div></div><div><span><span>  </span></span><span>- </span><span>packages/cli/src/commands/workflow.ts</span></div></div><div><div><div>6</div></div><div><span><span>  </span></span><span>- </span><span>packages/cli/test/commands/workflow*.test.ts</span></div></div><div><div><div>7</div></div><div><span>---</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>之后 AI 读或改到这些文件时，对应的规则会在那个时刻送过来。同一会话里已经送过、内容没变的，不会重复发，隔一段时间才用一个简短的提醒；spec 改了，或者会话被压缩过，就重新发完整内容。规则会出现在它要约束的那处修改旁边，而不是在会话开头说一句，聊了一百轮之后就被冲淡了。</p></section><section><h3>经验沉淀回 spec<a href="#经验沉淀回-spec"><span>#</span></a></h3><p>任务做完之后，<code>trellis-update-spec</code> 会判断这次有没有值得长期遵守的做法。有的话写进 <code>.trellis/spec/</code>，只跟这个任务有关的事实留在任务目录里。</p><p>文档里有一个说法我挺认同：用得越多，AI 越懂你们。前提是有人把 review 里反复出现的意见变成 spec。今天 review 里说了一句”这里要校验入参”，明天它就应该成为规范里的一条，不再需要有人每次说。</p></section><section><h3>跨会话记忆：记在文件里<a href="#跨会话记忆记在文件里"><span>#</span></a></h3><p>AI 本身没有跨会话的记忆，Trellis 的办法是让仓库来记。</p><p>每次 <code>finish-work</code> 会往 <code>.trellis/workspace/你的名字/journal-N.md</code> 追加一条，写这次做了什么。下一次会话启动时 hook 会读到近期的 journal 和进行中的任务。任务本身的需求、设计、调研也都留在 <code>.trellis/tasks/</code> 里。</p><p>文档里有句话说得很清楚：下一次 AI 会话会重新读取仓库状态，不需要上一段聊天记录，也能知道任务是什么、哪些 spec 适用、下一步该做哪一步。聊天记录压缩了、换了台电脑、换了个 AI 工具，都不影响。</p></section></section><section><h2>对团队：共享规范，不强制统一工具<a href="#对团队共享规范不强制统一工具"><span>#</span></a></h2><p>对公司来说，我觉得 Trellis 最有价值的是这一块。</p><p></p><figure><img src="https://imgbed.caph.me/file/1791913603682_image.png" alt="团队共享 .trellis/ 的方式：不同 AI 工具读取同一份规范，新规范经 PR 评审后合入仓库" /><figcaption>团队共享 .trellis/ 的方式：不同 AI 工具读取同一份规范，新规范经 PR 评审后合入仓库</figcaption></figure><p></p><p>分工大概是这样：</p><ul>
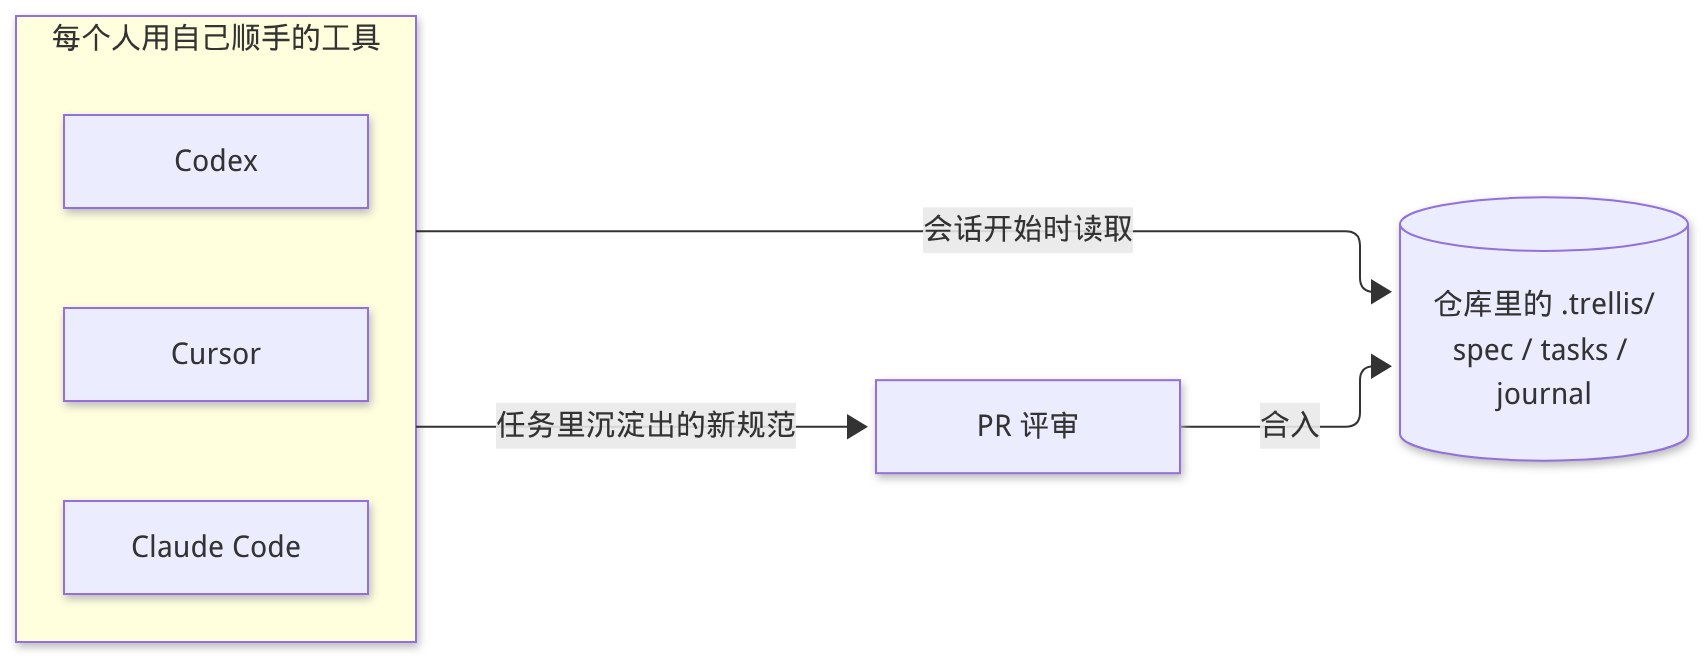
<li><code>.trellis/spec/</code> 和 <code>.trellis/tasks/</code> 进 git，团队共用。spec 的改动跟代码一样走 PR review。</li>
<li><code>.trellis/workspace/你的名字/</code> 是每个人自己的 journal，互不干扰。</li>
<li><code>.trellis/.developer</code>（你是谁）和 <code>.trellis/.runtime/</code>（当前会话在做哪个任务）不提交，每台机器、每个窗口各用各的，所以同一个仓库里开两个窗口做不同任务也不会串。</li>
</ul><p>新同事加入也简单：clone 仓库，跑一次 <code>trellis init</code>，选”Set up developer identity on this device”，填个名字就行。注意别选 Full re-initialize，那会覆盖掉已有配置，影响全团队。</p><p>这套东西带来的好处，是团队里有人把规范写好了，其他人的 AI 一起变好。有人用 Cursor，有人用 Claude Code，新人用 Codex，读的都是同一份。换工具的时候规范不用重写。</p></section><section><h2>使用成本<a href="#使用成本"><span>#</span></a></h2><p>介绍了这么多优点，也要说说代价，不然像在卖东西。</p><ul>
<li><strong>小任务会变慢。</strong> 它的节奏是先问清、再实现、再检查、最后收尾。改一行文案也走一遍就很重，所以它本来也允许跳过，直接 inline 做。</li>
<li><strong>空模板没用。</strong> <code>trellis init</code> 会放大约 17 个占位的 spec 文件，内容几乎是空的。要先做 bootstrap 任务，让 AI 从现有代码里提炼出第一版规范，再由人把关。直接拿空模板开始写业务，AI 读到的还是套话。</li>
<li><strong>各平台能力不一样。</strong> Cursor、Claude Code、OpenCode 这些有完整的 hook 和子代理。Codex 要在配置里打开 hook（<code>~/.codex/config.toml</code> 里写 <code>hooks = true</code>，0.129 及以后版本还要在 TUI 里用 <code>/hooks</code> 批准一次），不开的话只能靠 <code>AGENTS.md</code>。Kilo、Antigravity、Devin 这几个没有 hook，要手动进入工作流。</li>
<li><strong>要有人维护 spec。</strong> spec 不更新就会过时，建议当成代码来对待。</li>
<li><strong>需要 Node.js 18+ 和 Python 3.9+。</strong></li>
<li><strong>协议是 AGPL-3.0。</strong> 团队内部使用不需要额外授权，要基于它做商业化产品或服务才需要联系作者。</li>
</ul></section><section><h2>怎么开始试<a href="#怎么开始试"><span>#</span></a></h2><p>不用全员铺开，官方也建议先选一个仓库试点。</p><div><figure><figcaption><span></span><span>Terminal window</span></figcaption><pre><code><div><div><div>1</div></div><div><span>npm</span><span> </span><span>install</span><span> </span><span>-g</span><span> </span><span>@mindfoldhq/trellis@latest</span></div></div><div><div><div>2</div></div><div><span>cd</span><span> </span><span>your-project</span></div></div><div><div><div>3</div></div><div><span>trellis</span><span> </span><span>init</span><span> </span><span>-u</span><span> </span><span>your-name</span><span> </span><span>--cursor</span><span>   </span><span># 按你用的工具换成 --claude / --codex 等</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>装完之后的顺序我建议这样走：</p><ol>
<li>先跑 bootstrap 任务，让 AI 从真实代码里提出第一版 spec，自己过一遍。</li>
<li>日常直接说需求。AI 会判断要不要建任务，问你的时候确认就行。</li>
<li>它停下来或者跳步了，用 <code>/trellis:continue</code> 往下推进。</li>
<li>代码 commit 之后，用 <code>/trellis:finish-work</code> 归档并写 journal。</li>
<li>试用一两周，把 review 里重复出现的意见沉淀成 spec，看看新会话里要重复解释的东西有没有变少。</li>
</ol></section><section><h2>参考<a href="#参考"><span>#</span></a></h2><ul>
<li><a href="https://docs.trytrellis.app/zh" target="_blank">Trellis 官方文档</a></li>
<li><a href="https://docs.trytrellis.app/zh/advanced/architecture" target="_blank">架构全景</a></li>
<li><a href="https://docs.trytrellis.app/zh/start/how-it-works" target="_blank">How It Works</a></li>
<li><a href="https://docs.trytrellis.app/zh/advanced/multi-platform" target="_blank">多平台与团队配置</a></li>
<li><a href="https://docs.trytrellis.app/zh/start/real-world-scenarios" target="_blank">真实业务场景</a></li>
<li><a href="https://github.com/mindfold-ai/Trellis" target="_blank">Trellis on GitHub</a></li>
</ul></section></section>]]></content>
    </entry>
    <entry>
      <id>https://caph.me/posts/macos-%E6%8E%A8%E8%8D%90%E5%BA%94%E7%94%A8/</id>
      <title type="text">macOS 应用推荐</title>
      <published>2026-06-21T00:00:00.000Z</published>
      <updated>2026-06-21T00:00:00.000Z</updated>
      <author><name>Caph</name></author>
      <link rel="alternate" href="https://caph.me/posts/macos-%E6%8E%A8%E8%8D%90%E5%BA%94%E7%94%A8/"/>
      <summary type="text">记录一下我觉得好用的 macOS 的应用</summary>
      <content type="html"><![CDATA[<section><h2>效率工具<a href="#效率工具"><span>#</span></a></h2><ul>
<li>
<p>Deck：最好用的剪贴板 <a href="https://deckclip.app/" target="_blank">https://deckclip.app/</a></p>
</li>
<li>
<p>Alfred 5 多功能启动器</p>
<p>推荐的 Workflows：</p>
<ul>
<li>Alfred Gallery</li>
<li>Edit Clipboard</li>
<li>GitFred</li>
<li>New File</li>
<li>PathFind</li>
<li>Recent Files</li>
<li>Window Switcher</li>
</ul>
</li>
<li>
<p>BetterAndBetter：<a href="https://www.better365.cn/bab2.html" target="_blank">https://www.better365.cn/bab2.html</a> <strong>全局手势</strong></p>
</li>
<li>
<p>Hammerspoon：配合 <a href="/posts/%E5%BE%AE%E4%BF%A1%E8%BE%93%E5%85%A5%E6%B3%95/">微信输入法</a> <a href="/posts/%E8%B1%86%E5%8C%85%E8%BE%93%E5%85%A5%E6%B3%95/">豆包输入法</a> 使用 <a href="https://github.com/Paxxs/Doubao-ime-hammerspoon" target="_blank">https://github.com/Paxxs/Doubao-ime-hammerspoon</a></p>
</li>
<li>
<p>iGet：文本划选增强 <a href="https://www.better365.cn/h-col-197.html" target="_blank">https://www.better365.cn/h-col-197.html</a></p>
</li>
<li>
<p>Dropover：文件暂存架 <a href="https://dropoverapp.com/" target="_blank">https://dropoverapp.com/</a></p>
</li>
<li>
<p>Orbit：手势为主的径向应用切换器 <a href="https://github.com/yuzeguitarist/Orbit" target="_blank">https://github.com/yuzeguitarist/Orbit</a></p>
</li>
</ul></section>
<section><h2>终端与开发<a href="#终端与开发"><span>#</span></a></h2><ul>
<li>Ghostty：美观的终端模拟器，配合 <a href="https://github.com/lewislulu/terminal-setup" target="_blank">https://github.com/lewislulu/terminal-setup</a> 一键配置</li>
<li>Open Island：刘海区域的 Vibe Coding 伴侣 <a href="https://github.com/Octane0411/open-vibe-island" target="_blank">https://github.com/Octane0411/open-vibe-island</a></li>
<li>Zap：完全开放的 Agentic 终端 <a href="https://github.com/zerx-lab/zap" target="_blank">https://github.com/zerx-lab/zap</a></li>
</ul></section>
<section><h2>浏览器与网络<a href="#浏览器与网络"><span>#</span></a></h2><ul>
<li>代理客户端：
<ul>
<li><a href="https://github.com/clash-verge-rev/clash-verge-rev" target="_blank">https://github.com/clash-verge-rev/clash-verge-rev</a></li>
<li><a href="https://github.com/mihomo-party-org/clash-party" target="_blank">https://github.com/mihomo-party-org/clash-party</a></li>
<li><a href="https://github.com/chen08209/FlClash" target="_blank">https://github.com/chen08209/FlClash</a></li>
<li><a href="https://github.com/Kindness-Kismet/Stelliberty" target="_blank">https://github.com/Kindness-Kismet/Stelliberty</a></li>
</ul>
</li>
</ul></section>
<section><h2>媒体与设计<a href="#媒体与设计"><span>#</span></a></h2></section>
<section><h2>系统增强<a href="#系统增强"><span>#</span></a></h2><ul>
<li>Applite：图形化的 Homebrew <a href="https://github.com/milanvarady/applite" target="_blank">https://github.com/milanvarady/applite</a></li>
<li>BetterDisplay：外接显示器必备 BetterDisplay <a href="https://github.com/waydabber/betterdisplay" target="_blank">https://github.com/waydabber/betterdisplay</a></li>
<li>cmdX：实现 Windows 上的文件剪切 <a href="https://github.com/YONN2222/cmdX" target="_blank">https://github.com/YONN2222/cmdX</a></li>
<li>iTab：窗口管理和切换工具 <a href="https://www.aodo365.com/itab.html" target="_blank">https://www.aodo365.com/itab.html</a></li>
<li>LuLu：防火墙 <a href="https://github.com/objective-see/lulu" target="_blank">https://github.com/objective-see/lulu</a></li>
<li>Mac Mouse Fix：鼠标增强 <a href="https://github.com/noah-nuebling/mac-mouse-fix" target="_blank">https://github.com/noah-nuebling/mac-mouse-fix</a></li>
<li>QSpace Pro：更好用的 Finder <a href="https://qspace.awehunt.com/zh-cn/index.html" target="_blank">https://qspace.awehunt.com/zh-cn/index.html</a></li>
<li>State：监控 Mac 数据 <a href="https://www.better365.cn/state.html" target="_blank">https://www.better365.cn/state.html</a></li>
<li>Thaw：菜单栏管理 <a href="https://github.com/stonerl/Thaw" target="_blank">https://github.com/stonerl/Thaw</a></li>
<li>SoundSource：音量调节增强 <a href="https://rogueamoeba.com/soundsource/" target="_blank">https://rogueamoeba.com/soundsource/</a></li>
<li>TopNotch：刘海美化 <a href="https://topnotch.app/" target="_blank">https://topnotch.app/</a></li>
<li>Mole：命令行形式的优化和清理软件 <a href="https://github.com/tw93/mole" target="_blank">https://github.com/tw93/mole</a></li>
</ul></section>
<section><h2>安全与隐私<a href="#安全与隐私"><span>#</span></a></h2></section>
<section><h2>其他<a href="#其他"><span>#</span></a></h2><ul>
<li>WhatCable：告诉你插入 Mac 的每根线缆的参数 <a href="https://github.com/darrylmorley/whatcable" target="_blank">https://github.com/darrylmorley/whatcable</a></li>
</ul></section>]]></content>
    </entry>
    <entry>
      <id>https://caph.me/posts/agents-progressive-disclosure/</id>
      <title type="text">是时候精简你的 AGENTS.md 了——By 渐进式披露</title>
      <published>2026-05-28T00:00:00.000Z</published>
      <updated>2026-05-28T00:00:00.000Z</updated>
      <author><name>Caph</name></author>
      <link rel="alternate" href="https://caph.me/posts/agents-progressive-disclosure/"/>
      <summary type="text">用 agents-progressive-disclosure skill 把膨胀的 AGENTS.md 重构成精简路由入口与按需加载的专项文档。</summary>
      <content type="html"><![CDATA[<p>Agent 指令文件很容易越写越大。命令示例、搜索策略、包管理器规则、部署说明、工具细节……全堆进 <code>AGENTS.md</code> 或 <code>CLAUDE.md</code> 之后，每个任务都要为大量无关规则买单，最重要的常驻规则反而被稀释。</p>
<p><a href="https://github.com/Caph-dev/agents-progressive-disclosure" target="_blank">agents-progressive-disclosure</a> 是一个开源 agent skill，用来把这种「规则仓库」重构成<strong>精简路由入口 + 按需读取的专项文档</strong>——核心思想就是渐进式披露（Progressive Disclosure）。</p>
<a href="https://github.com/Caph-dev/agents-progressive-disclosure" target="_blank"><div><div><div><div></div><div>Caph-dev</div></div><div>/</div><div>agents-progressive-disclosure</div></div><div></div></div><div>A skill to refactor bloated AGENTS.md, CLAUDE.md, or similar agent instruction files into a compact routing entrypoint plus focused docs/ reference files.</div><div><div>—</div><div>—</div><div>no-license</div><span>Unavailable</span></div></a>
<blockquote><p>本文首发于 <a href="https://linux.do/t/topic/2263095" target="_blank">LINUX DO 社区</a>。</p></blockquote>
<section><h2>为什么需要精简<a href="#为什么需要精简"><span>#</span></a></h2><p>团队维护 agent 指令文件时，常见两类问题：</p><ol>
<li><strong>信号被稀释</strong>：最重要的规则和低频细节混在一起，agent 很难抓住重点。</li>
<li><strong>上下文成本过高</strong>：每个任务都加载整份百科全书，无关规则白白占用 token。</li>
</ol><p>渐进式披露的思路很直接：</p><ul>
<li>高频、长期有效、必须始终遵守的规则 → 留在入口文件</li>
<li>具体任务才需要的详细规则 → 下沉到 <code>docs/</code> 或平台专属规则文件</li>
<li>入口文件明确告诉 agent：<strong>遇到什么任务，先读哪份文档</strong></li>
</ul><p>一句话：<code>AGENTS.md</code> 应该是导航页，不应该是百科全书。</p></section>
<section><h2>安装<a href="#安装"><span>#</span></a></h2><p>推荐使用 <a href="https://github.com/vercel-labs/skills" target="_blank">skills CLI</a>：</p><div><figure><figcaption><span></span><span>Terminal window</span></figcaption><pre><code><div><div><div>1</div></div><div><span>npx</span><span> </span><span>skills</span><span> </span><span>add</span><span> </span><span>Caph-dev/agents-progressive-disclosure</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>其他常用选项：</p><div><figure><figcaption><span></span><span>Terminal window</span></figcaption><pre><code><div><div><div>1</div></div><div><span># 全局安装，所有项目可用</span></div></div><div><div><div>2</div></div><div><span>npx</span><span> </span><span>skills</span><span> </span><span>add</span><span> </span><span>Caph-dev/agents-progressive-disclosure</span><span> </span><span>-g</span></div></div><div><div><div>3</div></div><div>
</div></div><div><div><div>4</div></div><div><span># 只安装到 Cursor</span></div></div><div><div><div>5</div></div><div><span>npx</span><span> </span><span>skills</span><span> </span><span>add</span><span> </span><span>Caph-dev/agents-progressive-disclosure</span><span> </span><span>-a</span><span> </span><span>cursor</span><span> </span><span>-y</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>也可以直接把仓库链接发给你的 agent，让它帮你安装；Codex 用户可以手动克隆到 skills 目录：</p><div><figure><figcaption><span></span><span>Terminal window</span></figcaption><pre><code><div><div><div>1</div></div><div><span>git</span><span> </span><span>clone</span><span> </span><span>https://github.com/Caph-dev/agents-progressive-disclosure</span><span> </span><span>~/.codex/skills/agents-progressive-disclosure</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>安装后重启 agent，以便加载新 skill。</p></section>
<section><h2>使用方法<a href="#使用方法"><span>#</span></a></h2><p>在 agent 对话中输入：</p><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span>使用 $agents-progressive-disclosure，把当前 AGENTS.md 重构成精简入口文件和 docs/ 专项文档。</span></div></div></code></pre><div><div></div><div></div></div></figure></div><p>skill 会引导 agent 完成以下流程：</p><ol>
<li>完整读取现有指令文件</li>
<li>扫描相互矛盾的指令（风格、包管理器、测试命令、安全边界等）</li>
<li>把规则分类为<strong>常驻规则</strong>和<strong>任务细节</strong></li>
<li>设计精简的文档路由地图</li>
<li>重写入口文件为紧凑路由器</li>
<li>创建或更新聚焦的 <code>docs/</code> 文件</li>
<li>用 preservation checklist 验证规则没有丢失</li>
</ol><div><div><div></div><div>Tip</div></div><div><p>重构完成后，务必亲自检查一遍：当前策略会不会分得太细？有些常用流程是不是没必要放到 <code>docs/</code> 下？</p></div></div></section>
<section><h2>重构后的结构长什么样<a href="#重构后的结构长什么样"><span>#</span></a></h2><p>入口文件通常包含这几块：</p>

<table><thead><tr><th>模块</th><th>内容</th></tr></thead><tbody><tr><td>适用范围</td><td>说明这是全局还是项目级入口</td></tr><tr><td>常驻原则</td><td>必须始终遵守的高频规则</td></tr><tr><td>按需读取索引</td><td>任务类型 → 对应文档的路由表</td></tr><tr><td>常驻安全边界</td><td>破坏性操作、权限等底线规则</td></tr><tr><td>优先级</td><td>用户指令 &gt; 项目 AGENTS.md &gt; 全局 AGENTS.md &gt; docs 细则</td></tr></tbody></table><p>下面是我 Codex 全局 <code>AGENTS.md</code> 的简化示例（完整版见 <a href="https://github.com/Caph-dev/agents-progressive-disclosure" target="_blank">GitHub 仓库</a>）：</p><div><div><div><figure><figcaption></figcaption><pre><code><div><div><div>1</div></div><div><span># 全局 Agent 指令</span></div></div><div><div><div>2</div></div><div>
</div></div><div><div><div>3</div></div><div><span>&gt; 适用范围：本文件是全局代理行为入口。这里只保留必须常驻的规则；</span></div></div><div><div><div>4</div></div><div><span>&gt; 任务细节按需读取 </span><span><span>`</span><span>docs/</span><span>`</span></span><span> 下的专项文档。</span></div></div><div><div><div>5</div></div><div>
</div></div><div><div><div>6</div></div><div><span>## 常驻原则</span></div></div><div><div><div>7</div></div><div>
</div></div><div><div><div>8</div></div><div><span><span>-</span><span> 当前环境按 </span></span><span>**macOS 原生环境 + Ghostty + zsh**</span><span> 处理</span></div></div><div><div><div>9</div></div><div><span><span>-</span><span> 需要当前信息、官方文档、API 细节时，默认使用本机 </span></span><span><span>`</span><span>smart-search</span><span>`</span></span><span> CLI</span></div></div><div><div><div>10</div></div><div><span><span>-</span><span> 不要仅凭训练数据回答可能变化的事实</span></span></div></div><div><div><div>11</div></div><div><span><span>-</span><span> </span></span><span><span>`</span><span>AGENTS.md</span><span>`</span></span><span> 是路由入口，不是规则仓库；只读取与当前任务相关的专项文档</span></div></div><div><div><div>12</div></div><div>
</div></div><div><div><div>13</div></div><div><span>## 按需读取索引</span></div></div><div><div><div>14</div></div><div>
</div></div><div><div><div>15</div></div><div><span>| 任务类型 | 先读文档 | 触发条件 |</span></div></div><div><div><div>16</div></div><div><span>| -------- | -------- | -------- |</span></div></div><div><div><div>17</div></div><div><span>| 联网搜索、网页抓取、API/SDK 用法 | </span><span><span>`</span><span>docs/search-and-evidence.md</span><span>`</span></span><span> | 需要当前信息、来源链接、高风险事实核验 |</span></div></div><div><div><div>18</div></div><div><span>| 本地环境、Shell、Homebrew | </span><span><span>`</span><span>docs/local-environment.md</span><span>`</span></span><span> | 需要运行命令、改 shell 配置、安装工具 |</span></div></div><div><div><div>19</div></div><div><span>| 项目命令、包管理器、Git | </span><span><span>`</span><span>docs/project-workflow.md</span><span>`</span></span><span> | 需要构建、测试、安装依赖、提交代码 |</span></div></div><div><div><div>20</div></div><div>
</div></div><div><div><div>21</div></div><div><span>## 优先级</span></div></div><div><div><div>22</div></div><div>
</div></div><div><div><div>23</div></div><div><span><span>1.</span><span> 用户当前明确指令</span></span></div></div><div><div><div>24</div></div><div><span><span>2.</span><span> 当前项目或更近目录的 </span></span><span><span>`</span><span>AGENTS.md</span><span>`</span></span></div></div><div><div><div>25</div></div><div><span><span>3.</span><span> 本文件</span></span></div></div><div><div><div>26</div></div><div><span><span>4.</span><span> 本文件路由到的 </span></span><span><span>`</span><span>docs/*.md</span><span>`</span></span><span> 细则</span></div></div></code></pre><div><div></div><div></div></div></figure><div></div></div><span>展开</span><span>收起</span></div></div></section>
<section><h2>好处<a href="#好处"><span>#</span></a></h2><ol>
<li><strong>AGENTS.md 保持精简</strong>——入口文件只承担路由职责</li>
<li><strong>省上下文</strong>——无关规则不再每次全量加载</li>
<li><strong>技术文档可以写得很详细</strong>——只有需要时才读取；也可以进一步提炼为独立 skill</li>
<li><strong>更容易维护</strong>——按主题拆分，改一处不影响全局</li>
</ol><p>有佬友说这种模式像 MoE（混合专家）：路由不同的专家处理不同任务。本质上和 wiki 的分层索引是同一类思路。</p></section>
<section><h2>常见问题<a href="#常见问题"><span>#</span></a></h2><section><h3>Agent 一定会去读对应的 docs 吗？<a href="#agent-一定会去读对应的-docs-吗"><span>#</span></a></h3><p>坦白说，<strong>不能保证 100%</strong>。大模型是概率系统，强模型大多会遵守读取规则，但偶发忽略也是可能的。</p><p>降低遗漏概率的做法：</p><ul>
<li>在路由表里写清楚触发条件，而不是只列文件名</li>
<li>对 plan / code / review 等不同阶段分别指定要加载的规则</li>
<li>更进一步：用 <strong>hooks 强制注入</strong>索引，在任务开始时把相关文档片段自动塞进上下文</li>
</ul></section><section><h3>常用规则要不要也放到 docs 里？<a href="#常用规则要不要也放到-docs-里"><span>#</span></a></h3><p>没必要。渐进式披露的目标是把<strong>低频、任务相关</strong>的细节下沉，而不是把每天都用的规则藏起来。</p><p>比如 response style、文件搜索策略这类几乎每次都会用到的内容，继续放在入口文件更合适。过度拆分反而会增加路由成本和维护负担。</p></section><section><h3>文件太大会有截断问题吗？<a href="#文件太大会有截断问题吗"><span>#</span></a></h3><p>会。有佬友反馈，当核心文件达到约 18KB 时，部分 agent 应用可能触发截断，导致文件中后段的规则 agent 根本看不到——这时候整理就不仅是优化，而是刚需了。</p></section></section>
<section><h2>相关链接<a href="#相关链接"><span>#</span></a></h2><ul>
<li>GitHub：<a href="https://github.com/Caph-dev/agents-progressive-disclosure" target="_blank">Caph-dev/agents-progressive-disclosure</a></li>
<li>skills.sh：<a href="https://skills.sh/Caph-dev/agents-progressive-disclosure" target="_blank">agents-progressive-disclosure</a></li>
<li>社区讨论：<a href="https://linux.do/t/topic/2263095" target="_blank">LINUX DO 原帖</a></li>
</ul><p>欢迎试用、提 Issue，也欢迎在社区继续交流你的 AGENTS.md 治理经验。</p></section>]]></content>
    </entry>
</feed>